先建立一張概念地圖
依序點過四個詞,看看它們各自位在什麼位置。全部看完,才算完成這張地圖。
最外層的領域
AI 是一個廣泛的領域
它描述讓機器產生像辨識、預測、生成與決策等能力的技術與系統。影像辨識、推薦系統與生成文字,都可以放在 AI 這把大傘下。
設計情境:自動去背、圖片生成與文字整理,都是不同的 AI 應用。
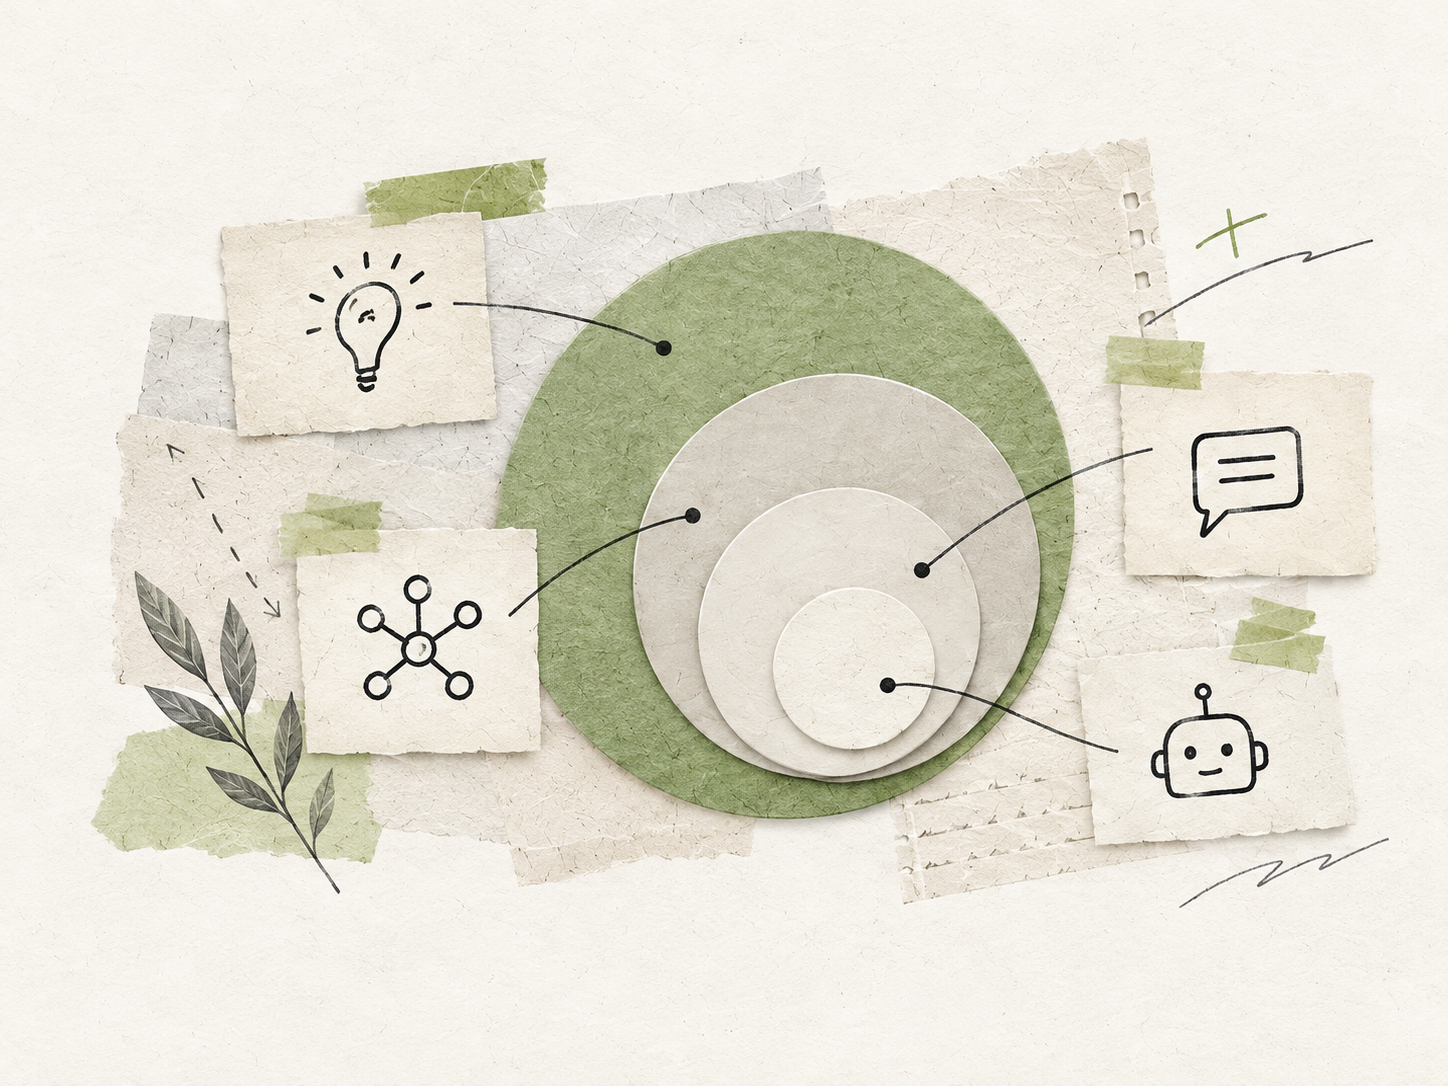
這是概念關係圖,不是四層分類或產品演進順序。LLM 是模型的一類;Agent 則是組合模型、工具與流程的系統,因此在圖中獨立標示。
模型:把輸入轉成結果的方法
模型不是一個會自己思考的角色。你可以先把它想成一套從資料學到的結構與參數:收到輸入後,依照學到的模式產生預測或結果。
不同模型擅長的任務不同:有些處理影像,有些處理聲音,有些以語言為核心;多模態模型也能結合不同類型的輸入。
選一份輸入
可能的模型結果
把需求分成目標、受眾、限制與交付項目 語言模型處理文字輸入LLM:以語言為核心的大型模型
LLM 是 Large Language Model 的縮寫。它從大量語言資料中學習文字與語意的模式,再根據你提供的上下文,一步步產生接下來的內容。
以語言為核心,不代表只能接收文字;部分相關模型也支援圖片、音訊等多模態輸入,實際能力依模型而異。因此它能整理、改寫、問答與協助推論;但「文字看起來合理」不等於內容一定正確,重要資訊仍要核對。
不是 AI 的同義詞。
互動練習
猜猜下一段最合理的文字
「這份設計提案最需要先釐清的是 ____。」
Agent:讓模型在流程中使用工具
Agent 通常是一套以模型為核心的任務系統。它不只產生一句回答,還會依目標決定下一步、呼叫被允許的工具、查看結果,再判斷要繼續、修正或交回使用者。
能做到多少,取決於它擁有的工具、資料、權限、流程與防護規則。Agent 並不是「完全自主」的保證。
目標
先知道要完成什麼
「根據資料夾裡的客戶需求,整理一份提案初稿。」這是任務目標,不是每一步的詳細指令。
放回設計工作:同一句需求,差在哪裡?
以下不是能力高低的比較,而是工作範圍不同。切換看看「問模型」與「交給 Agent」各自會發生什麼。
「幫我準備這次品牌提案。」
主要產出:文字回覆
先提供一份可用的提案大綱
- 根據對話裡的資訊整理段落
- 提出策略、流程與頁面建議
- 不知道資料夾裡還有哪些檔案
你仍需要自己開啟資料、建立檔案並檢查內容。
最後,用四句話收好
- AI廣泛的技術與系統領域。
- 模型從資料學到模式,將輸入轉成結果。
- LLM以語言為核心的一類大型模型。
- Agent讓模型在目標、工具與流程中採取多步行動的系統。
30 秒理解測驗